多言語マニュアルで翻訳修正が“無間地獄”になる理由 – Arkanos Insights
言語マニュアルの翻訳修正では、翻訳済みデータの再取り込みや共有トピックの変更によって、作業済みだった情報が再び翻訳中に戻ることがあります。XMLのエクスポート・インポートだけでは整理できない、翻訳対象・返却範囲・取り込み範囲・作業済み状態の扱いについて考えます。
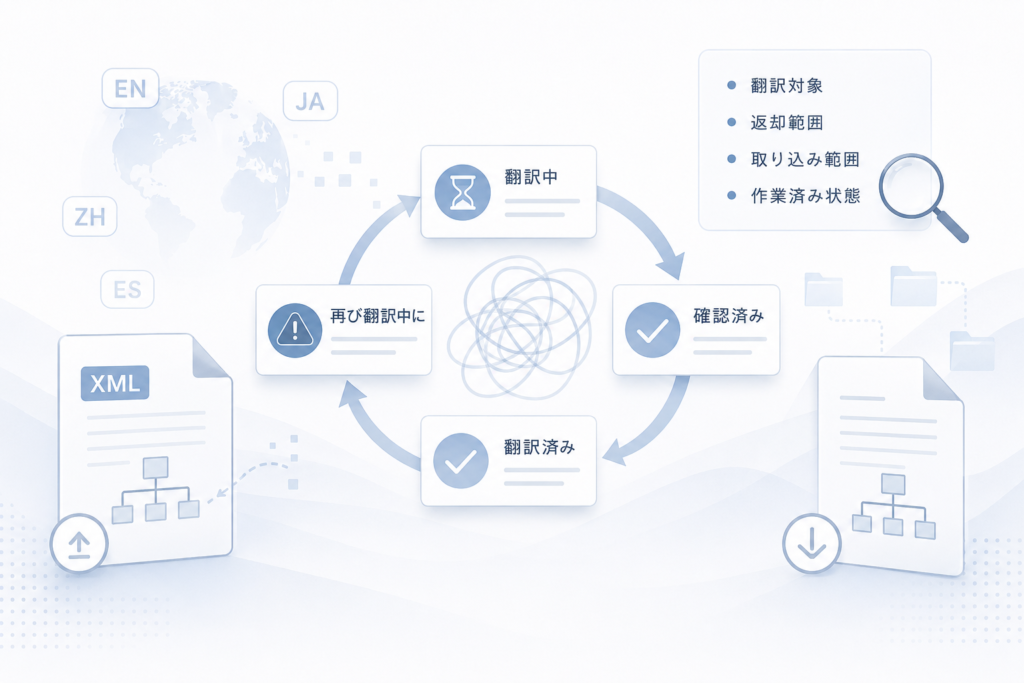
多言語マニュアルの運用では、一度翻訳が完了し、翻訳済みになったはずの内容が、再び翻訳中の状態に戻ることがあります。
翻訳は終わったはずなのに、また翻訳中になる。
確認済みだったはずなのに、再確認が必要になる。
あるマニュアルの修正だったはずなのに、別のマップにも影響が出る。
こうした状態が続くと、現場では「どこまで終わっているのか」「何を確認すればよいのか」が分かりにくくなります。
多言語マニュアルの翻訳修正が複雑になる理由は、翻訳品質だけではありません。
問題の本質は、翻訳対象、返却対象、取り込み対象、そして作業済み状態の意味が整理されないまま、XMLのエクスポートとインポートだけで運用しようとしてしまうことにあります。
構造化コンテンツでは、ひとつの修正が複数マップに影響する
DITAやCCMSを使った構造化コンテンツでは、同じトピックを複数のマップで再利用できます。
これは大きなメリットです。
同じ情報を一元管理でき、重複を減らし、改訂時の修正箇所も減らせます。
しかし、再利用されているトピックを後から変更する場合、その変更は再利用先すべてに影響する可能性があります。
あるマップでは必要な修正でも、別のマップではすでに翻訳完了、確認完了、リリース済みの情報かもしれません。
つまり、構造化コンテンツでは「再利用できる」ことと「いつでも自由に変更してよい」ことは同じではありません。
特に多言語展開では、共有トピックの変更が翻訳ステータスやリリース済みデータに影響するため、修正の適用範囲を明確にする必要があります。
翻訳済みになったはずの内容が、なぜまた翻訳中に戻るのか
多言語マニュアルの運用では、一度翻訳済みになったはずのトピックが、再び翻訳中の状態に戻ることがあります。
その理由のひとつが、翻訳ファイルの返却範囲です。
たとえば、現地側に翻訳を依頼した際、実際に翻訳が必要だったのは一部のファイルだけだったにもかかわらず、依頼時に渡したファイル一式が翻訳後ファイルとして返却されることがあります。
現地側としては、依頼されたファイルを一式返しているだけで、必ずしも誤った対応をしているわけではありません。
「依頼されたものはすべて返す」
「一部だけ返すと不足が出るかもしれない」
「渡されたファイル一式を作業後に戻すのが自然だ」
そう考えるのは、作業フローとしては理解できます。
しかし、受け取り側でそのファイル一式をそのまま取り込むと、実際には変更していないトピックまで再取り込みの対象になります。
その結果、過去に翻訳済みになっていたトピックが翻訳中に戻ったり、そのトピックを使用している別のマップにも影響が出たりします。
問題は、現地側が正しく作業していないことではありません。
返却する側にとって自然な作業フローと、取り込む側が必要としている作業範囲がずれていることにあります。
「全部戻す」運用が、余計なステータス変更を生む
翻訳済みファイルを一式戻されると、受け取り側では次のような問題が起きます。
- 翻訳済みだったトピックが翻訳中に戻る
- 実際には変更していないファイルに差分が出る
- 不要なレビューや確認が発生する
- 別マップへの影響確認が必要になる
- 取り込み前に、対象ファイルと非対象ファイルを切り分ける作業が発生する
本来、受け取り側が必要としているのは、実際に翻訳または修正されたファイルです。
しかし、依頼時に渡したファイル一式がそのまま返却されると、どこが本当に翻訳されたのか、どこは単に同梱されているだけなのかを判断する必要が出ます。
この切り分け自体が、運用上の負荷になります。
「新規翻訳したファイルだけを戻してください」とルールに書くだけで解決する場合もあります。
ただし、現場の作業フローやシステム上の操作がそれに合っていなければ、結局は従来どおり一式返却される可能性があります。
ルールとして伝えるだけでは不十分です。
依頼時点で翻訳対象を明確にし、返却時にもどのファイルが実際に翻訳されたものなのか分かる形にしておく必要があります。
bookmapやsubmapまで返却されると、取り込み前の切り分けが必要になる
翻訳運用では、本文トピックだけでなく、bookmapやsubmapまで返却対象に含まれることがあります。
しかし、bookmapやsubmapは、本文そのものというより、章立てや参照関係を管理するための構成情報です。
通常、原文側と翻訳側でbookmapの構造が変わることは想定しにくいものです。
にもかかわらず、返却されたmapファイルをそのまま取り込もうとすると、要素数の違いや構造差分によってバリデーションエラーになることがあります。
この場合、問題は翻訳文の品質ではありません。
どのファイルを取り込み対象とし、どのファイルを除外すべきかを判断する作業が発生していること自体が問題です。
翻訳対象と返却対象が曖昧なままだと、翻訳後の取り込み前に、余計な切り分け作業が発生します。
これは、XMLのエクスポート・インポートだけで整理できる問題ではありません。
翻訳データは「別言語の本文」であって、「別管理のソース」ではない
多言語マニュアルでは、地域、言語、法規、販売仕様によって内容差分が発生することがあります。
そのため、現場ではターゲット言語側だけにタグやスタイル指定を追加して対応したくなる場面があります。
一時的な対応としては、そうせざるを得ない場合もあります。
しかし、原文と訳文のタグ構造が変わると、翻訳取込、再翻訳、差分比較、他機種流用で問題が起きやすくなります。
翻訳データは、基本的には原文と1対1で対応する前提で管理されます。
翻訳データは「別言語の本文」であって、「別管理のソース」ではありません。
地域固有の要件を、翻訳文側の個別修正だけで吸収しようとすると、原文と訳文の対応関係が崩れていきます。
その結果、次回以降の翻訳や再利用で、どこが正式な差分なのか、どこが一時対応なのか分かりにくくなります。
地域差分は、どこで管理するかを設計する
地域固有の要件がある場合、それをどこで管理するかを設計する必要があります。
たとえば、次のような選択肢があります。
- bookmapを分ける
- 専用トピックを作る
- ditavalで条件分岐する
- 出力設定で制御する
- 原文側の構造を見直す
- リリースブランチで管理する
ditavalによる切り分けは有効です。
同じトピックの中で条件ごとの差分を管理できるため、再利用性を保ちながら出力を切り分けられます。
ただし、ditavalを使えばすべて解決するわけではありません。
条件が増えすぎると、トピックが巨大化します。
編集負荷も上がります。
翻訳対象の文字数や確認範囲が増え、翻訳費用にも影響します。
特殊な仕向地や販売仕様については、個別bookmapや専用トピックとして分けた方が、運用上安定する場合もあります。
重要なのは、暫定対応をすること自体ではありません。
暫定対応を恒久運用にしてしまうことです。
一時的にターゲット言語側で対応することがあっても、それをどこかのタイミングで原文、構造、条件分岐、リリース管理のどこに戻すのかを決めておく必要があります。
修正指示を分類する
翻訳修正と一口に言っても、その中身はさまざまです。
たとえば、次のような種類があります。
- 誤訳の修正
- 用語統一
- 表現ルールの調整
- 言語固有の自然さの改善
- 法規や地域要件への対応
- 機種固有の内容差分
- 一時的な回避策
- 原文側の不備に起因する修正
- DITA構造や再利用設計に起因する修正
これらをすべて同じ「翻訳修正」として扱うと、どこに反映すべき修正なのか分からなくなります。
TMに反映すべきなのか。
用語集に反映すべきなのか。
原文を修正すべきなのか。
DITA構造を見直すべきなのか。
リリースブランチで管理すべきなのか。
修正の種類によって、反映先は変わります。
翻訳文だけを直せばよい場合もあれば、原文や情報構造そのものを見直すべき場合もあります。
ここを整理しないまま取り込みだけを進めると、翻訳修正はどんどん複雑になります。
作業済みの意味を守るには、状態を固定・追跡する必要がある
翻訳運用では、一度作業済みになったものを日常的に動かしすぎないことも重要です。
翻訳済み・確認済みになった内容は、理由がない限り、その時点で利用可能な状態として扱うべきです。
そこを頻繁に翻訳中へ戻してしまうと、現場にとって「作業済みとは何か」が分かりにくくなります。
一方で、翻訳品質や用語統一を改善していくには、TMや用語集を継続的に育てていく必要があります。
そのため、日常運用では新規翻訳や必要な修正だけを積み上げ、制作の谷間や一定期間ごとの見直しタイミングで、TM、用語、表現ルールを整理する流れが望ましいです。
このタイミングであれば、作業済みだったデータを再度取り込み対象にすることにも意味があります。
重要なのは、日々の制作中に作業済み状態をむやみに揺らさないことです。
作業済みの意味を守る。
そのうえで、翻訳資産を見直すタイミングを別に設ける。
この切り分けが必要です。
システム化すれば解決するとは限らない
返却範囲のズレを減らす方法として、翻訳依頼や返却をシステム化する方法があります。
たとえば、現地側がWebインターフェース上で翻訳対象を確認し、実際に翻訳した内容だけを登録できるようにすれば、ファイル一式をメールや共有フォルダでやりとりする必要は減ります。
このような仕組みがあれば、次の情報を管理しやすくなります。
- どのファイルを翻訳対象としたのか
- どのファイルが実際に更新されたのか
- どこまでを返却対象とするのか
- どこまでを取り込み対象とするのか
- どのデータは作業済みとして維持するのか
ただし、システム化すれば必ず解決するわけではありません。
既存のCCMSや翻訳管理システムに近い機能がある場合もあります。
運用に合わせた追加開発が必要になる場合もあります。
逆に、システム側の機能に業務を無理に合わせることで、現場の作業が分かりにくくなることもあります。
重要なのは、先に運用を整理することです。
どの情報を翻訳対象とするのか。
どの範囲を返却してもらうのか。
どのファイルを取り込むのか。
何を除外するのか。
どの状態を作業済みとして維持するのか。
これらを整理したうえで、運用ルールで対応するのか、CCMSや翻訳管理システムの機能を使うのか、独自の仕組みを用意するのかを判断する必要があります。
翻訳運用は、文章の問題ではなく情報管理の問題である
多言語マニュアルの翻訳運用で重要なのは、翻訳文そのものだけではありません。
何を翻訳対象とし、何を翻訳対象外とするのか。
何を返却してもらい、何を取り込み対象にするのか。
どの状態の情報を作業済みとして維持するのか。
地域差分や仕様差分を、どこで管理するのか。
修正内容を、TM、用語集、原文、DITA構造、リリースブランチのどこに反映するのか。
これらを整理しないままXMLのエクスポートとインポートだけで運用しようとすると、不要なステータス変更、再確認、別マップへの影響確認が発生します。
翻訳運用は、文章の受け渡しではありません。
情報の状態管理を含む業務設計です。
再利用は効率化の手段です。
しかし、変更管理なしに再利用すると、翻訳運用の手戻りを増やします。
作業済みの意味を守る。
翻訳対象を明確にする。
返却範囲と取り込み範囲を分ける。
地域差分をどこで管理するか決める。
翻訳資産を見直すタイミングを設ける。
多言語マニュアルの翻訳修正を“無間地獄”にしないためには、XMLをどう出し入れするかだけでなく、翻訳対象と情報の状態をどう管理するかを設計する必要があります。